原本我使用的模型是 gemini-3.6-flash,一開始沒遇到什麼問題。當初只是想說換成表現更好、等級更高的模型去測試,沒想到剛測試就遇到一個早該想到的問題:用量限制。
測到一半系統直接掛給你看,而且必定是第一次呼叫就失敗。
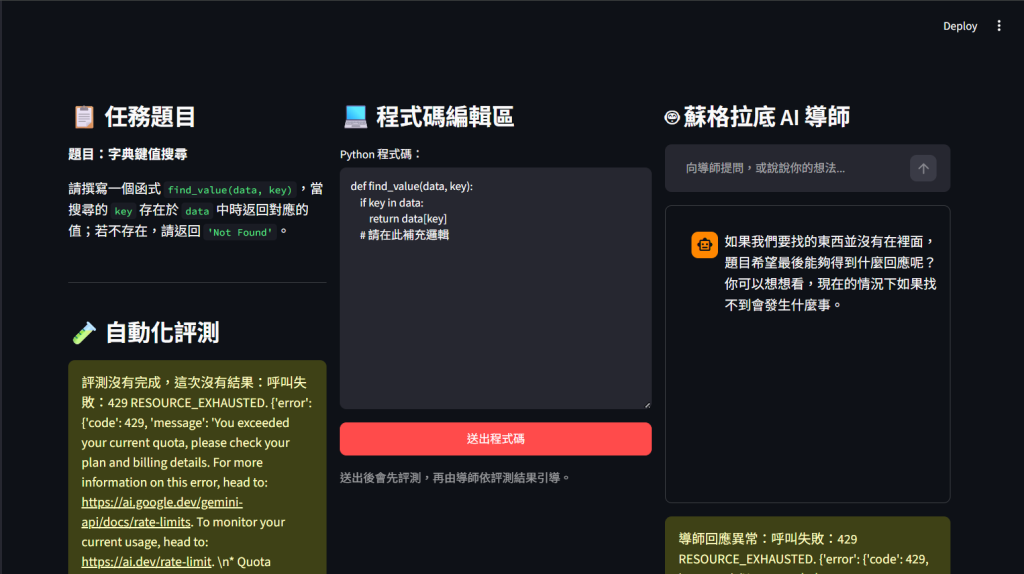
從 UI 畫面上可以清楚看到連鎖報錯:
-
左欄(自動化評測 Agent):
429 RESOURCE_EXHAUSTED (You exceeded your current quota...)
-
右下角(導師 Agent):
導師回應異常:呼叫失敗:429 RESOURCE_EXHAUSTED
根本原因:雙 Agent 造成的配額雙倍消耗
這印證了目前系統架構的運作方式:當學生按下「送出程式碼」時,系統會在同一次互動中先後呼叫 評測 Agent 與 導師 Agent。
這兩次 API 呼叫在幾百毫秒內連續發出,一旦高階模型的帳號配額達到上限(例如免費或測試層級的每日限制),兩個 Agent 就會同時在 API 閘道端被退回。
解決方法
解決方法其實也很簡單,就是把模型切換/降級成 gemini-3.5-flash-lite,大幅提高用量上限與呼叫額度,避免在測試階段頻繁遇到配額耗盡的情況。
反思與處置
-
配額防禦機制:一次 UI 操作連發兩次 LLM 請求(評測 + 導師)會加倍消耗 API Quota。未來應該在第一個 Agent(評測)失敗時,就立即阻止第二個 Agent(導師)繼續呼叫,並做降級提示。
-
引進沙盒 (Sandbox) 的必要性:這也再次證明未來引進真實沙盒的必要。把「評測」從 LLM 推測改為沙盒實跑,不僅能省下評測 Agent 的 LLM 呼叫次數,還能徹底避免 API Rate Limit 導致改作業失敗的問題。


 iThome鐵人賽
 看影片追技術